عیبیابی پیشرفته و کدهای خطای حیاتی در سرورهای HPE ProLiant Gen10: از LEDهای IML تا کدهای POST و رفع بحرانهای سختافزاری
عیبیابی پیشرفته سرورهای HPE ProLiant Gen10 نیازمند تحلیل دقیق کدهای POST، بررسی وضعیت Integrated Management Log و پایش LEDهای تشخیصی Health است. برای رفع خطاهای سرور hp و بحرانهای سختافزاری، بررسی سلامت زیرسیستمهای iLO، کنترلر RAID و ماژولهای حافظه RAM کلید اصلی بازگردانی پایداری زیرساخت دیتاسنتر است. در دنیای پیچیده فناوری اطلاعات امروزی، سرورها به عنوان قلب تپنده دیتاسنترها عمل میکنند و هرگونه توقف ناخواسته یا خرابی سختافزاری در آنها میتواند خسارتهای جبرانناپذیری به کسبوکارها وارد کند. بنابراین، داشتن دانش عمیق، ابزارهای تشخیصی استاندارد و رویکرد ساختاریافته برای مدیران زیرساخت و مهندسان شبکه یک ضرورت انکارناپذیر محسوب میشود تا در کوتاهترین زمان ممکن، ریشه بحران را شناسایی و برطرف نمایند.
پاسخ سریع: عیبیابی پیشرفته سرورهای HPE ProLiant Gen10 با بررسی لاگهای Integrated Management Log (IML)، پایش وضعیت LEDهای System Health و تحلیل کدهای POST انجام میشود. دسترسی Out-of-Band از طریق iLO 5، بررسی ماژولهای SmartMemory و کنترلر Smart Array راهکارهای اصلی برای شناسایی و رفع بحرانهای سختافزاری در این سرورها هستند. این فرآیند به مدیران سیستم اجازه میدهد حتی در زمان قطعی کامل سیستمعامل، وضعیت حیاتی قطعات را رصد کرده و از بروز فجایع دادهای جلوگیری کنند.
فهرست مطالب
- مقدمه و تعریف کدهای بحرانی در سرورهای HPE Gen10
- معماری مانیتورینگ و نقش iLO 5 در عیبیابی سختافزار
- تحلیل تخصصی کدهای POST و وضعیت LEDهای System Health
- عیبیابی تخصصی زیرسیستمهای CPU، RAM و کنترلر RAID
- جدول مقایسه وضعیت LEDها و کدهای خطای حیاتی
- راهنمای گامبهگام (Step-by-Step) رفع بحرانهای سختافزاری
- سوالات متداول (FAQ) و پاسخهای تخصصی
- نتیجهگیری
روشهای تخصصی و اصول کلیدی برای رفع خطاهای سرور hp و مدیریت Integrated Management Log
سامانه مدیریت یکپارچه در سرورهای اچپیئی (HPE) به عنوان یک بازوی نظارتی قدرتمند عمل میکند که به صورت ۲۴ ساعته بر تمام اجزای سختافزاری نظارت دارد. برای درک بهتر این چرخه و نحوه ثبت و پردازش رویدادها، بررسی جزئیات زیر حائز اهمیت است:
- ثبت دقیق وقایع سختافزاری توسط فرمور مستقل iLO 5 حتی در زمان خاموش بودن سیستمعامل؛ این ویژگی تضمین میکند که هیچ رویدادی از دید سیستم پنهان نمانده و تاریخچه کاملی از وضعیت تغذیه، دما و سلامت بورد اصلی ذخیره شود.
- تحلیل کدهای خطای پیشبینیکننده شکست (Predictive Failure Analysis – PFA) پیش از بروز خرابی قطعی در قطعات حیاتی نظیر هارد درایوها، ماژولهای رم و فنها، که به تیمهای فنی فرصت میدهد پیش از از دست رفتن سرویس، قطعه معیوب را تعویض کنند.
- ارتباط لاگهای سختافزاری با سیستمعاملهای مجازیساز مانند VMware ESXi و Microsoft Hyper-V جهت مانیتورینگ سطح بالا و ارسال هشدارهای آنی (SNMP Traps یا Email Alerts) به مراکز عملیاتی شبکه (NOC).
- سناریوی واقعی: فرض کنید در یک دیتاسنتر سازمانی، یکی از ماژولهای حافظه رم به دلیل نوسان ولتاژ دچار خطاهای تصحیحپذیر (Correctable ECC Errors) مکرر میشود. سامانه IML پیش از اینکه این خطا به یک Crash صفحه آبی (BSOD) در سیستمعامل تبدیل شود، آن را به عنوان هشدار ثبت کرده و مدیر سیستم را وادار به تعویض پیشگیرانه ماژول میکند.
مدیریت بحران iLO 5 و پایش سلامت زیرساخت سرورهای Gen10 چگونه انجام میشود؟
استفاده بهینه از ابزارهای مدیریتی نسل پنجم iLO به مدیران شبکه اجازه میدهد تا کنترل کامل و همهجانبهای بر زیرساخت سختافزاری داشته باشند؛ حتی اگر سرور در یک موقعیت جغرافیایی دوردست یا رکهای غیرقابل دسترس قرار گرفته باشد. ابعاد کلیدی این مدیریت پیشرفته عبارتند از:
- استفاده از رابط Dedicated iLO Port برای دسترسی Out-of-Band در زمان قطعی کامل سیستمعامل و بروز بحرانهای اساسی بوت، که به مهندس سیستم اجازه میدهد از طریق کنسول گرافیکی تحت وب (HTML5 Integrated Remote Console) سرور را مدیریت کند.
- بررسی Intelligent Provisioning و ابزارهای Active Health System (AHS) برای استخراج لاگهای جامع تشخیصی که شامل بیش از یک گیگابایت دادههای تلمتری سختافزاری، تغییرات پیکربندی و وضعیت سلامت قطعات در طول زمان است.
- پایش یکپارچگی ارتباطی سرور با بستر شبکه و تجهیزات ذخیرهسازی SAN/NAS جهت جلوگیری از قطعی مسیرهای دیتای حیاتی و اطمینان از پایداری پروتکلهای انتقال داده مانند iSCSI و Fibre Channel.
- مثال شهودی: تصور کنید سرور اصلی شرکت به دلیل خرابی فایلهای بوت سیستمعامل اصلاً بالا نمیآید و صفحه سیاه نمایش میدهد. با استفاده از قابلیت Virtual Media در iLO 5، میتوانید فایل ISO سیستمعامل یا ابزار نجات را از راه دور به سرور متصل کرده و بدون نیاز به حضور فیزیکی در دیتاسنتر، سیستم را بوت و عیبیابی کنید.
عیبیابی تخصصی ماژولهای حافظه RAM و پایداری پردازنده CPU در بحرانهای POST چطور صورت میگیرد؟
هنگامی که سرور در مرحله Power-On Self-Test (POST) متوقف میشود و از لود کردن فرمور اصلی سر باز میزند، معمولاً نشاندهنده خطاهای بحرانی و ساختاری سختافزاری است که نیازمند دانش عمیق الکترونیکی و معماری پردازندههاست:
- تحلیل خطاهای مربوط به پاریتی و ECC در ماژولهای HPE SmartMemory برای جلوگیری از خرابیهای ناگهانی حافظه و از دست رفتن دادههای در حال پردازش در حافظه کش.
- شناسایی کدهای خطای بحرانی CPU Machine Check Exception (MCE) که نشاندهنده ناپایداری در سطح پردازنده، خطاهای کش داخلی L1/L2/L3 یا اشکال در ارتباط بین سوکتهای چندگانه پردازنده (UPI Interconnect) است.
- بررسی خطاهای ناسازگاری باس حافظه و تاخیرهای کلاک پردازندههای Intel Xeon Scalable در زمان بوت سیستم که معمولاً ناشی از ترکیب نادرست ماژولهای رم با سرعتهای مختلف یا پر کردن غیرسنتی اسلاتها (Memory Population Rules) رخ میدهد.
- سناریوی فرضی: اگر در یک سرور ProLiant DL380 Gen10 Plus پس از ارتقای رم، سیستم در کدهای POST روی عبارت “Processor 1 Error: Machine Check Exception” متوقف شود، دلیل آن میتواند اعمال فشار بیش از حد به هیتسینک، کج شدن پایههای سوکت پردازنده (CPU Socket Pins) در هنگام نصب یا عدم تطابق فرکانس رم با کنترلر حافظه داخل CPU باشد.
بررسی خطاهای کنترلر RAID و آسیبپذیریهای زیرسیستم Storage چه اهمیتی دارد؟
زیرسیستم ذخیرهسازی یکی از حساسترین و حیاتیترین بخشهای هر دیتاسنتر مدرن است که کوچکترین ناپایداری در آن میتواند منجر به از دست رفتن حجم عظیمی از دادههای حیاتی سازمان شود، لذا عیبیابی آن نیازمند دقت فوقالعادهای است:
- تحلیل خطاهای Smart Array Controller و وضعیت کش باتری (F1/F2 Smart Storage Battery / FBWC) برای جلوگیری از آسیب به دادههای در حال نوشتن در سناریوهای قطع ناگهانی برق شهری.
- عیبیابی درایوهای NVMe و خطاهای ارتباطی PCIe در سرورهای ProLiant Gen10 در زمان عدم شناسایی هارد دیسکها یا افت شدید سرعت I/O به دلیل مشکلات گذرگاه PCIe و بایوس کنترلر.
- بازسازی رید (Rebuild) و مدیریت درایوهای Failed در سناریوهای بحرانی برای بازگردانی سلامت آرایه ذخیرهسازی، و بررسی نحوه عملکرد قابلیت Hot Spare برای جایگزینی اتوماتیک درایوهای معیوب.
- دلیل فنی و چگونگی: کنترلرهای HPE Smart Array با استفاده از حافظه کش محافظتشده با فلش (FBWC)، نوشتن دادهها را تسریع میکنند. اگر باتری این ماژول ضعیف شود، کنترلر به دلایل امنیتی کش را غیرفعال کرده (Write-Through Mode) که این امر کارایی دیسکها را تا دهها برابر کاهش داده و خطاهای متعددی در IML ایجاد میکند.
مقایسه نشانگرهای LED و کدهای بحرانی سیستم Health در سرورهای Gen10
جدول زیر مقایسهای جامع، کاربردی و دقیق میان وضعیتهای مختلف هشدار سختافزاری در پنل جلویی و داخلی سرورهای HPE ProLiant Gen10 ارائه میدهد تا تکنسینهای فنی بتوانند در نگاه اول وضعیت بحران را دستهبندی کنند:
| نوع نشانگر / خطا | وضعیت ظاهری / کد | معنای بحران و اقدام urgent |
|---|---|---|
| System Health LED | سبز ثابت (Green) | سیستم در وضعیت کاملاً نرمال و بدون هیچگونه مشکل سختافزاری یا هشداری است. |
| System Health LED | کهربایی چشمکزن (Amber Flashing) | وجود یک هشدار بحرانی (Critical Alert) مانند خرابی فن، قطع یکی از پاورها یا خطای PFA؛ نیاز به بررسی فوری IML و تعویض قطعه. |
| System Health LED | قرمز ثابت (Red Solid) | خطای مرگبار سختافزاری (Hardware Failure)؛ سیستم ممکن است ریست شده یا بوت نشود و نیاز به خاموشی کامل و بررسی مادربرد دارد. |
| POST Error Code | خطاهای کدهای بوق (Beep Codes) یا پیامهای نمایشی | نشاندهنده عدم شناسایی قطعات حیاتی، خطای پاریتی RAM، خرابی اسلات PCIe یا خطای اساسی در سوکت CPU است. |
| UID LED (Unit Identification) | آبی چشمکزن (Blue Flashing) | برای پیدا کردن فیزیکی سرور در رکهای شلوغ دیتاسنتر از طریق دستورات راه دور iLO استفاده میشود. |
راهنمای گامبهگام (Step-by-Step) عیبیابی و بازیابی سختافزاری سرور Gen10
برای رفع بحرانهای سختافزاری سختگیرانه و بازگردانی پایداری در سرورهای HPE ProLiant Gen10، دنبال کردن یک الگوریتم استاندارد و گامبهگام الزامی است. مراحل زیر را به ترتیب ذکر شده اجرا کنید:
- گام اول: قطع کامل برق و تخلیه الکتریسیته ساکن (Flea Power Drain)
کابلهای برق را از پشت سرور جدا کرده و دکمه Power جلویی را به مدت ۳۰ الی ۴۵ ثانیه فشار دهید تا شارژ باقیمانده در خازنهای مادربرد و مدارات الکترونیکی کاملاً تخلیه شود. این کار بسیاری از قفلهای سختافزاری منطقی (Logic Latches) را ریست میکند.
- گام دوم: بررسی اتصال فیزیکی رایزرها، کابلهای برق و ماژولهای رم
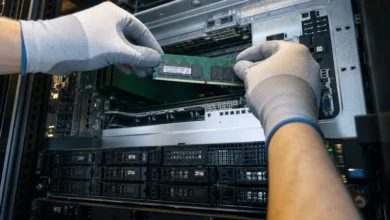
درب سرور را با رعایت اصول ایمنی ESD باز کرده و از صحت جایگذاری صحیح ماژولهای HPE SmartMemory در اسلاتهای مشخصشده، رایزرهای PCIe و کابلهای برق داخلی پاورها اطمینان حاصل کنید. گردوغبار موجود را با هوای فشرده پاک کنید.
- گام سوم: ریست سختافزاری NVRAM از طریق سوییچهای System Maintenance Switch روی مادربرد
با تغییر وضعیت دیپسوییچ مربوط به Clear NVRAM و System Configuration روی برد اصلی (معمولاً سوییچ شماره ۶ یا دکمه مخصوص S1/S2)، تنظیمات BIOS را به حالت پیشفرض کارخانه بازگردانید تا خطاهای پیکربندی آسیبدیده پاک شوند.
- گام چهارم: بهروزرسانی فرمور iLO و BIOS از طریق Intelligent Provisioning
پس از بالا آمدن نسبی سرور، از طریق ابزار Intelligent Provisioning یا محیط مدیریتی iLO، فرمور تمامی کامپوننتها اعم از BIOS، کنترلر Smart Array، پاورها و ماژول iLO را به آخرین نسخه پایدار ارائهشده توسط HPE آپدیت کنید.
- گام پنجم: تست نهایی پایداری و تست استرس سختافزاری (Stress Testing)
پس از اتمام مراحل تعمیر، با استفاده از ابزارهای تشخیصی تعبیهشده در سرور (HPE UEFI System Utilities -> Diagnostics)، تستهای جامع حافظه، پردازنده و دیسک را اجرا کنید تا از رفع قطعی مشکل مطمئن شوید.
سوالات متداول (FAQ) و پاسخهای تخصصی
این وضعیت نشاندهنده بروز یک خطای غیرمترقبه یا هشدار پیشبینیکننده شکست (Predictive Failure) در یکی از اجزای حیاتی سختافزاری مانند ماژول پاور، فنهای خنککننده، یا کنترلر RAID است که باید بلافاصله از طریق لاگ iLO بررسی شود تا از خرابی کامل سیستم جلوگیری گردد.
با ورود به وبسایت مدیریتی iLO 5 از طریق پورت اختصاصی Out-of-Band و وارد کردن اطلاعات احراز هویت، به بخش Information و سپس Integrated Management Log مراجعه کرده و گزارشات کامل لاگها را به صورت فایل CSV یا متن مشاهده و دانلود کنید.
ابتدا ماژولهای رم را از اسلات خارج کرده، پایههای طلایی آنها را با الکل ایزوپروپیل و باد سرد تمیز کنید و دوباره در اسلاتهای اصلی (مطابق راهنمای پاپولیشن HPE بر روی درب سرور) جا بزنید. در صورت تداوم خطا، ماژول معیوب را تعویض کنید.
خرابی یا اتمام عمر باتری کش (FBWC) باعث غیرفعال شدن کش رید کنترلر شده و خطاهای متعددی در IML ثبت میکند که روی کارایی IO زیرسیستم ذخیرهسازی تأثیر منفی دارد. تعویض این باتری یا ماژول کاپاسیتور برای بازگشت سرعت سرور الزامی است.
با استفاده از System Maintenance Switch روی مادربرد و تغییر حالت دیپسوییچ شماره ۶ (Clear NVRAM) به حالت ON و روشن کردن موقت سرور، تمام تنظیمات و پسوردهای BIOS پاک شده و به حالت کارخانه بازمیگردد.
سیستم Intelligent Provisioning ابزاری برای نصب آسان سیستمعامل و پیکربندی اولیه سرور است، در حالی که Active Health System (AHS) به صورت مداوم وضعیت سلامت سختافزار را مانیتور و لاگبرداری میکند تا در مواقع بروز بحران، عیبیابی سریعتر انجام شود.
نتیجهگیری
عیبیابی پیشرفته سرورهای HPE ProLiant Gen10 نیازمند تسلط کامل بر ابزارهای نظارتی مدرن مانند iLO 5، تحلیل دقیق کدهای POST، بررسی لاگهای جامع IML و شناخت عمیق نشانگرهای سختافزاری است. با دنبال کردن راهنمای فنی و مهندسی زیرساخت سرور، رعایت نکات ایمنی تخلیه الکتریسیته ساکن و پایش مستمر وضعیت سلامت سیستم، میتوانید پایداری، امنیت و دسترسپذیری دیتاسنتر سازمانی خود را تضمین کنید و در برابر خطاهای پیشبینینشده آمادگی کامل داشته باشید. همین حالا برای بررسی وضعیت لاگهای سرور خود اقدام نمایید و زیرساخت خود را بیمه کنید!
بازبینیشده توسط تیم فنی HPE24 / Falnic
این مقاله در لابراتوار فنی تخصصی بررسی و با آخرین مستندات مرجع مطابقت داده شده است. برای تضمین پایداری و صحت دادهها، کلیه کدهای ساختاری و متدهای اجرایی این محتوا تحت نظارت مهندسین ارشد شبکه و زیرساخت ما ارزیابی شدهاند.